ここからは別の話だ
前の三編はモデルを作る話だった。ここからは、出来上がったモデルが私たちの質問に答えを作り出す話、つまり推論だ。
この二つを分けておくことが重要だ。学習はモデル内部の値を変える作業であり、推論は一度も変わっていないモデルをただ使う作業だ。実務の会話で最も頻繁に食い違うのがこの点である。
チャット欄に文章を入れて送信を押した瞬間から、答えが一文字ずつ出てくるまで、内部で何が起きているのかを順番に追ってみよう。
まず数字になる
入力した文章は、第1編で見たとおりトークンに分割される。そしてすべてのトークンには固有の番号が付いている。語彙表が20万個なら、0番から20万番まで番号が振られていることになる。
そのため文章はまず番号の並びに変わる。ところが番号だけでは足りない。17番と18番の意味が近いという保証はないからだ。番号は単なる名札にすぎない。
そこで各番号を、意味を含んだ数字の束に変換する。この変換を埋め込みと呼ぶ。埋め込みを経ると、意味の近いトークン同士が数値のうえでも近い位置に置かれる。
埋め込みという言葉に馴染みがあるとすれば、RAGですでに聞いたからだろう。文書をベクトルに変えてベクトルデータベースに入れる、というときのあの埋め込みと同じ概念だ。最終編で再び登場する。
推論器は何重にも重なっている
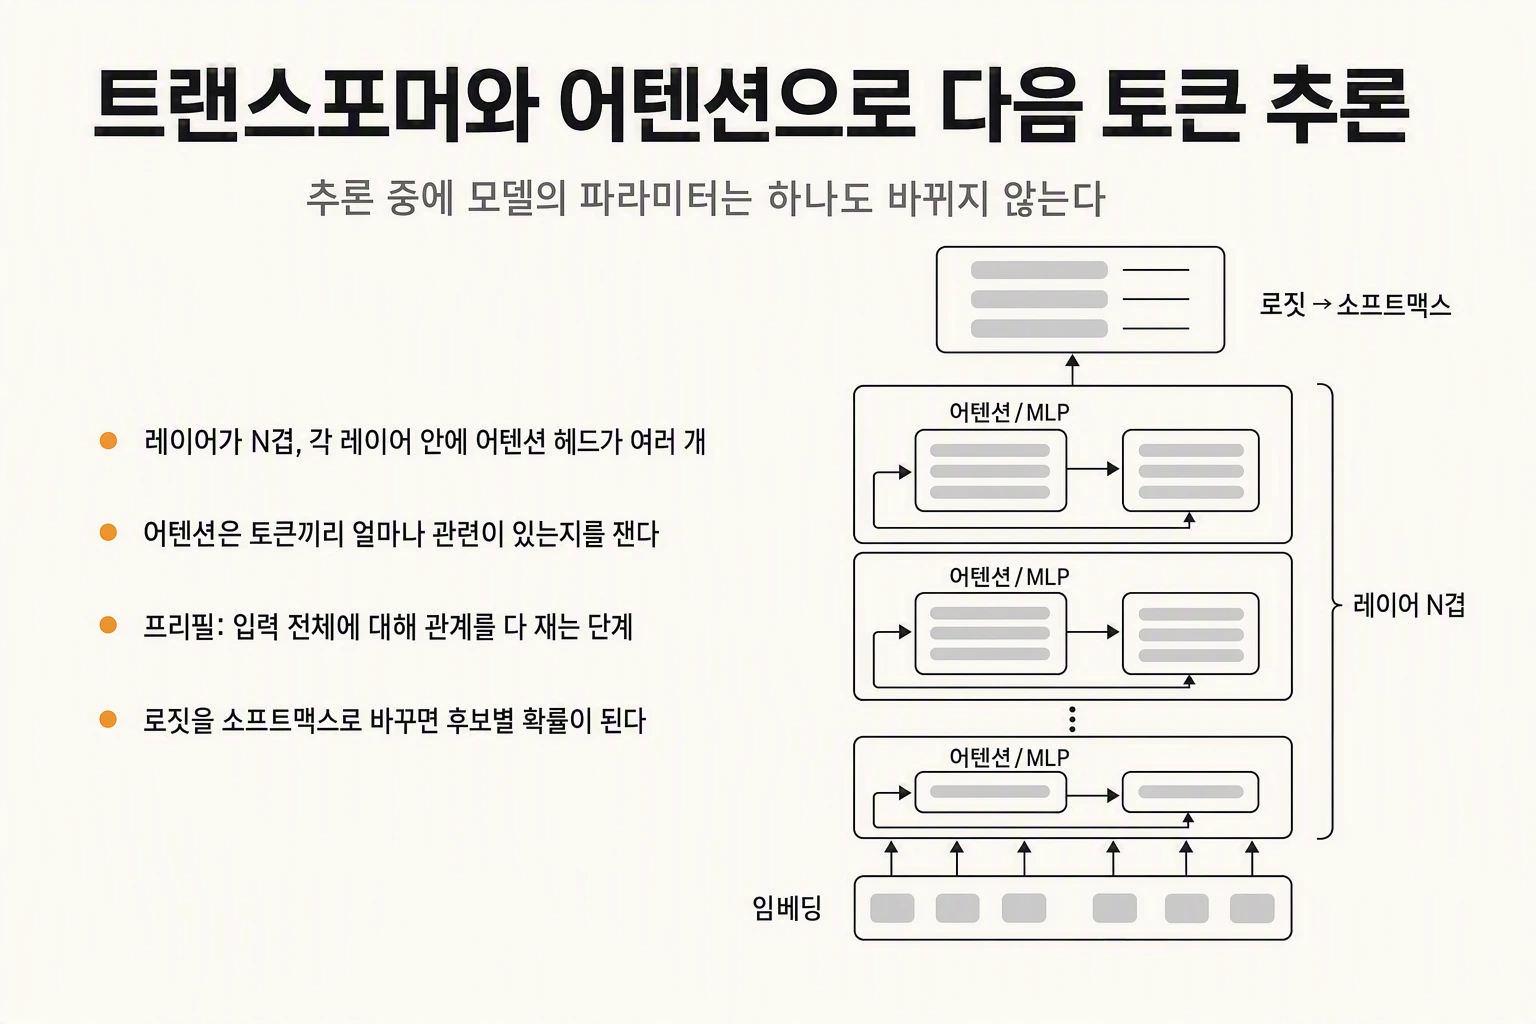
埋め込みまで終わると、いよいよ本格的な推論が始まる。推論器は層と呼ばれるものが何重にも積み重なった構造だ。
層1を通過した結果が層2に入り、それが層3に入る、という形でN重を通り抜ける。そして各層の中で起きることは事実上同じである。
なぜ同じことを何度も繰り返すのか。一度では関係を十分につかめないからだ。層を通るほど候補が精緻になる。そのため層の数が多いほど、一回の推論にかかる計算が増える。
この構造を指す名前がトランスフォーマーだ。LLMは、トランスフォーマーという方式で次のトークンを推論する仕組みである。
アテンション — 関係を測る作業
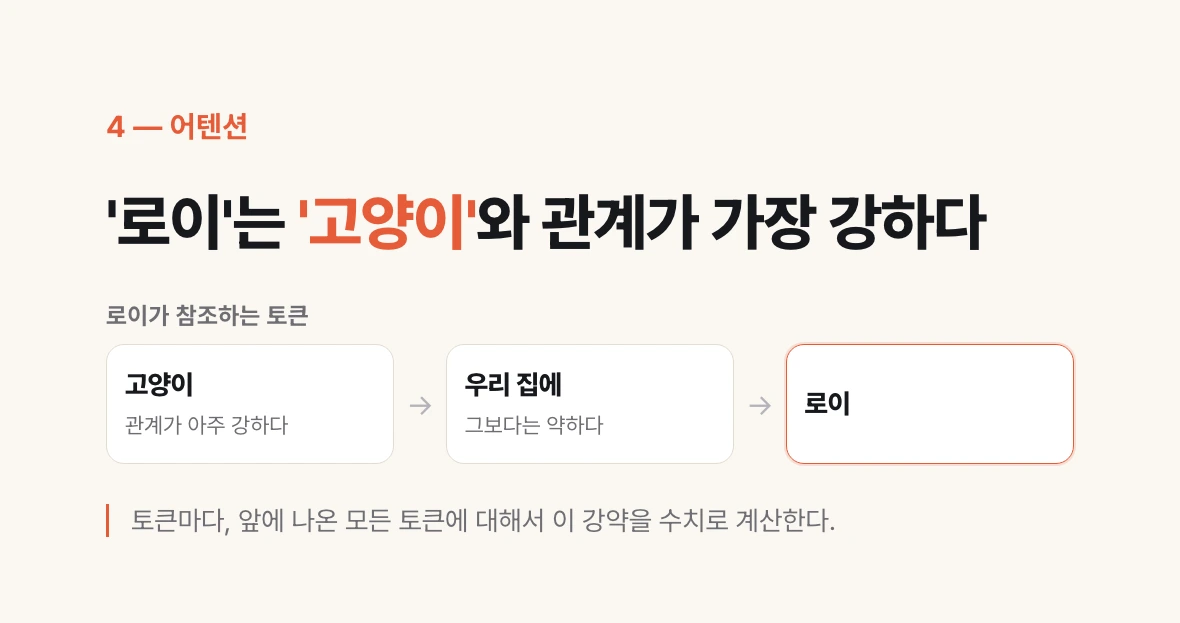
層の中で行われる中心的な処理がアテンションだ。やっていることは一文で要約できる。トークン同士がどれだけ関連しているかを測ることである。
例を挙げてみよう。「うちの猫の名前はロイです。品種はベンガルです。ロイはうちに住んでいる猫です。」
ここで最後の文の「ロイ」は、前の文の「猫」と非常に強い関係を持つ。「うちに」ともある程度の関係はあるが、それよりは弱い。アテンションはこの強弱をすべて数値として計算する。トークンごとに、前に出てきたすべてのトークンに対して。
そして計算した値をそのままにしておくと特徴がぼやける。そこで後処理を一度かけて、目立つものをさらに目立たせる。この後処理の部分をMLPと呼ぶ。
このアテンション計算自体も、層の中で複数の系統に分かれて同時に行われる。その系統の一つをアテンションヘッドと呼ぶ。つまり層がN重あり、各層の中にヘッドがさらに複数ある。繰り返しの繰り返しなので、実際の計算回数は非常に大きくなる。
なぜこの方式が流れを変えたのか
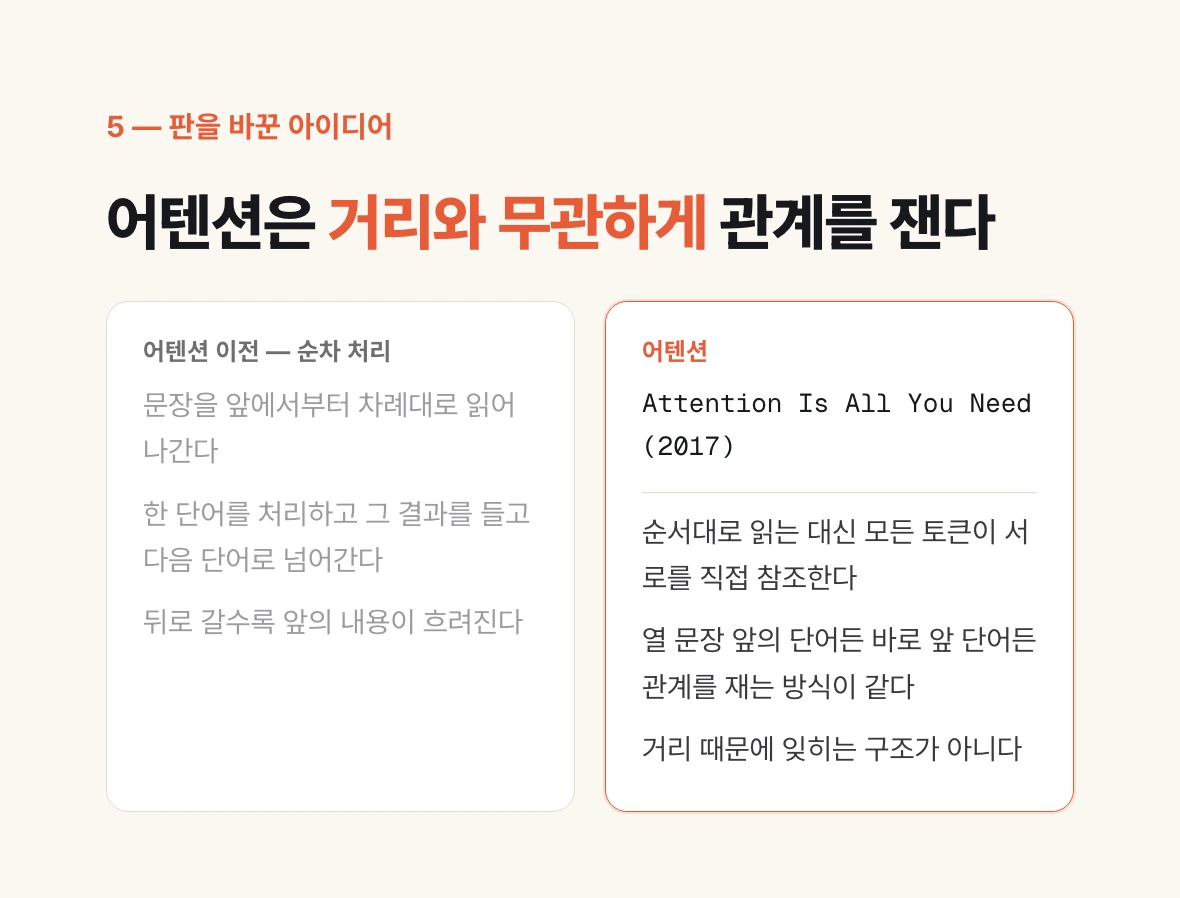
アテンションが登場する前の自然言語処理は、文を先頭から順に読んでいく方式が主流だった。一つの単語を処理し、その結果を持って次の単語に移る、という形である。
この方式には構造的な弱点があった。後ろに進むほど前の内容が薄れていくことだ。短い文では問題にならないが、小説のような長い文章で、前に出た名前を後ろで「それ」と受けると、何を指しているのか見失った。
アテンションは順番に読む代わりに、すべてのトークンが互いを直接参照できるようにする。十文前の単語でも直前の単語でも、関係を測る方式は同じだ。距離のせいで忘れられる構造ではない。
このアイデアを示したのが、2017年のGoogle研究陣による論文「Attention Is All You Need」だ。今使われているほとんどすべてのLLMがここから枝分かれした。発表当時は研究陣自身も、これほどの波及を予想していなかった。
送信を押したあと少し止まる理由
チャット欄に長い文章を貼り付けて送ると、少し止まってから答えが出始める。そのあとは文字が速く続いていく。
最初に止まっている間に行われているのが、先ほど見たアテンション計算だ。入力全体について関係をすべて測る段階であり、この区間をプリフィルと呼ぶ。
ここで見落としやすいことがある。計算の対象は私たちが入力した文章だけではない。目に見えないシステムプロンプト、それまでの会話履歴、各種の設定値が一緒に入る。画面に見えているものがすべてではない。
そのため入力が長くなると、この待ち時間は目に見えて増える。会話が長引くほど最初の応答が遅くなるのも同じ理由だ。毎回それまでの履歴を計算に入れ直すからである。
候補に点数が付けられる
層をすべて通過すると、次に来るトークンの候補が点数とともに出てくる。学習を終えたモデルなので、「昼食のメニューは」の次に自動車が1位で来ることはない。食べ物の名前が上位に並ぶ。
このとき出てくる値は確率ではなく、ただの点数だ。4.3、1.7、0.4のような数字であり、負の数も出る。この生の点数をロジットと呼ぶ。
そのままでは扱いにくいので、全部を足すと1になるように変換する。すると各候補が何パーセントなのかとして読める。この変換をソフトマックスという。
こうして「次に来るトークンの候補とそれぞれの確率」が出来上がった。ここまでが、一つのトークンを選ぶための準備である。
推論の最中にモデルは変わらない
ここで必ず押さえておくべきことがある。ここまで見てきた推論の過程で、モデルのパラメータは一つも変わらない。
第2編で見た調整つまみは、学習のときに合わせられたまま固定されている。推論は、その固定された設定で計算を流していく作業だ。つまみを動かすのは学習だけであり、それは計算コストがまったく別の次元なので、会話の最中に起こることはない。
そのため「昨日教えたのに今日はまた知らない」という現象が生じる。会話で伝えた内容は、その会話の入力に入っていただけで、モデルに刻まれたことは一度もない。新しい会話を開けば、その入力は消える。
同じ質問に対して昨日と今日で答えが違うのも、学習のせいではない。その理由は次の編で見る。
まだ一文字も出ていない
ここまでで候補の一覧と確率が出てきた。ところが答えはまだ一文字も出ていない。この中から実際に何を選ぶかが残っているからだ。
1位を常に選べばよさそうだが、そうはしない。そしてその選び方が、私たちがAPIで触るtemperature、top-k、top-pという値である。
次の編では、その選ぶ段階を見る。同じ質問に対して答えが毎回少しずつ変わる理由はそこにある。