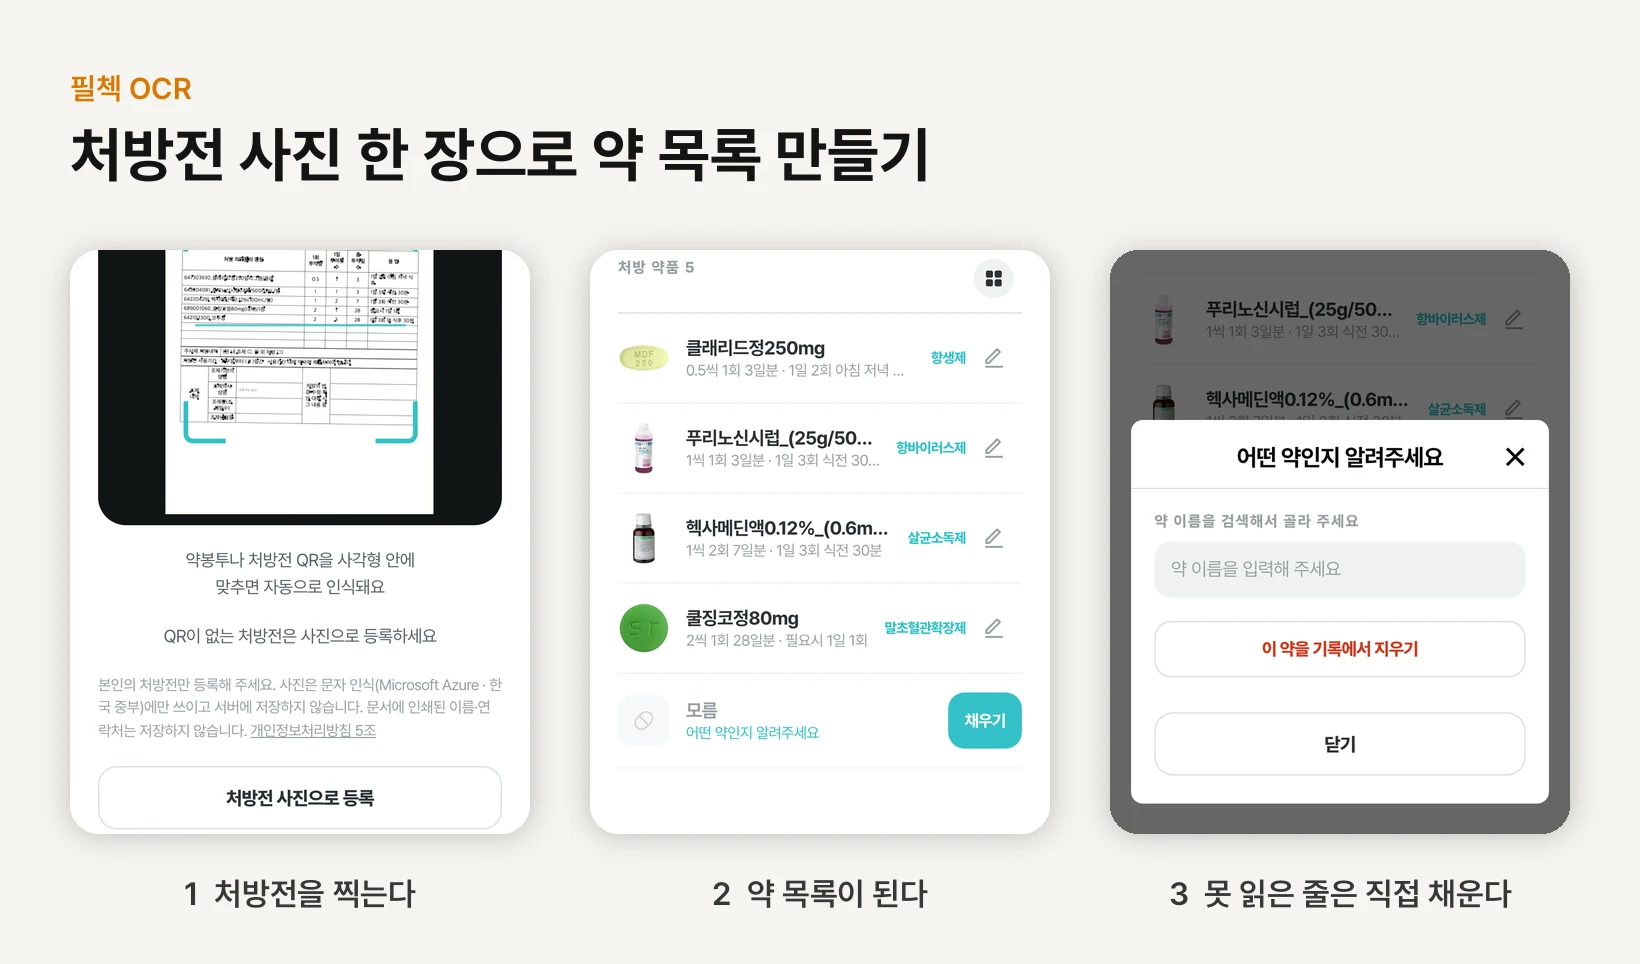
PillCheck OCR は何をする機能か
PillCheck は、自分が飲んでいる薬の効能・副作用・相互作用と調剤履歴を一か所で確認できるサービスです。薬を記録するいちばん速い方法は薬袋や処方箋のQRコードを読み取ることですが、QRコードが印刷されていない処方箋も多く、ほかの薬局でもらった薬袋は形式がばらばらです。その空白を埋めるのが写真登録です。
OCR(光学文字認識)は、写真の中の文字を読み取り、コンピューターが扱える文字に変える技術です。PillCheck OCR はこの技術で処方箋と薬袋の医薬品の表を読み取り、服薬リストを作ります。登録画面は処方箋・薬袋・錠剤の3つのタブに分かれていて、写真登録は前の2つのタブにあります。錠剤タブは、錠剤の写真から薬を見分ける別の機能です。
処方箋タブの下にある灰色の文字が、この機能の約束です。日本語に訳すと「ご本人の処方箋だけを登録してください。写真は文字認識(Microsoft Azure・韓国中部)にのみ使われ、サーバーには保存しません。文書に印刷された氏名・連絡先は保存しません。」となります。この約束をコードがどう守っているかは、以下で説明します。
pillcheck.co.kr での使い方
アプリのインストールは不要です。スマートフォンのブラウザで www.pillcheck.co.kr を開き、4つの手順に従います。
1つ目、ログインします。写真の読み取りはログインしたユーザーだけが使えます。2つ目、画面下のメニューで「スキャン」(스캔)を押すと登録画面が開きます。3つ目、手元の文書に合わせて「処方箋」(처방전)または「薬袋」(약봉투)タブを選びます。4つ目、「処方箋の写真で登録」(처방전 사진으로 등록)を押して撮影します。薬袋タブでは、同じ位置のボタンが「薬袋の写真で登録」(약봉투 사진으로 등록)になります。
薬袋は、薬の名前と飲み方の表がよく見えるように平らに置いて撮るのがコツです。文書にQRコードがあれば、写真よりQRコードのほうが速いです。同じ画面の四角の中にQRコードを合わせると自動で認識されます。
一連の流れは1分あまりの使い方動画(韓国語)にもまとめました。https://youtu.be/q5hYerY6ZO0
撮った後に何が起きるのか
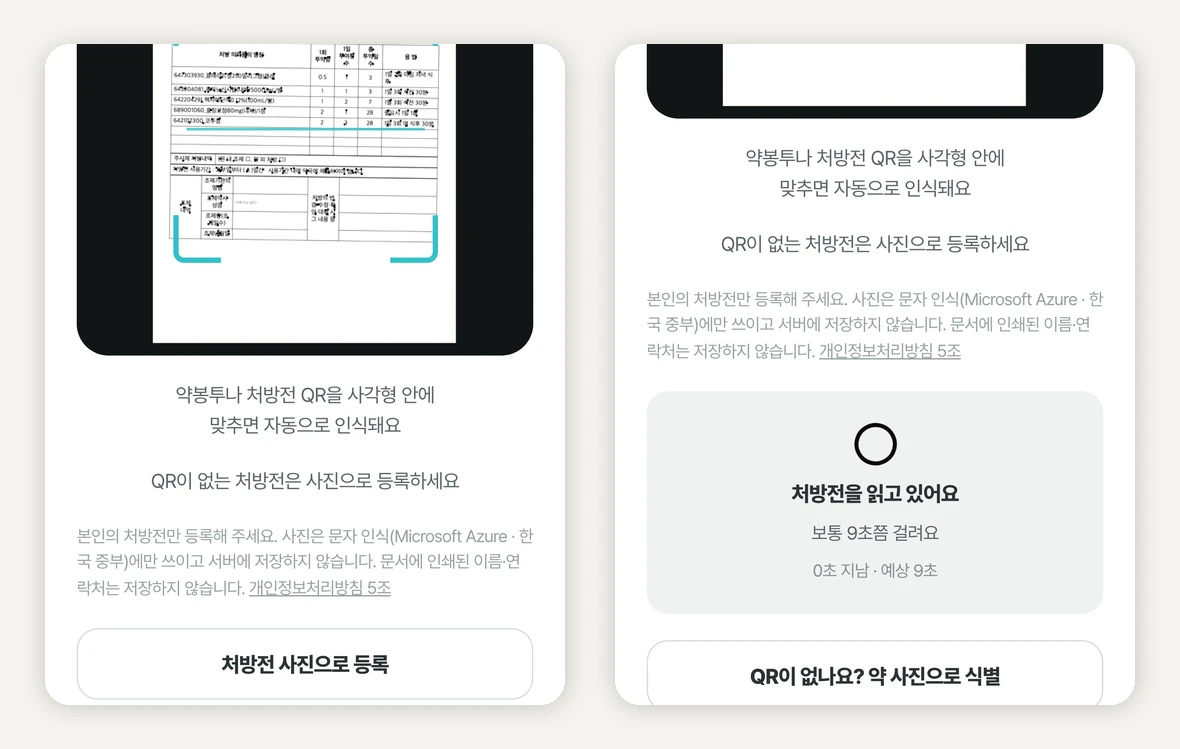
写真はすぐにはサーバーへ送られません。まずスマートフォンが写真を検査します。小さすぎる、暗すぎる・明るすぎる、手ぶれでぼやけている場合は、その場で撮り直しを求めます。読めない写真を送っても、間違った結果か空の結果が返ってくるだけだからです。
検査を通った処方箋の写真は縮小してサーバーへ送られ、サーバーはそれをマイクロソフトの文字認識AI、Azure Document Intelligence に渡します。このAIは文字だけでなく表のマス目の構造まで読み取り、どの数字が何番目の薬の投薬量なのかを見分けます。読み取りの信頼度が低ければ、サーバーは値を一つも返さず、撮り直しだけを求めます。間違った値が読み取れた値のように見えないようにするための設計です。
薬の名前は写真から書き写しません。韓国の処方箋には、薬ごとにEDIコードが印刷されています。国民健康保険が薬ごとに割り当てた9桁の番号です。PillCheck はこの番号を読み取って医薬品データベースで正式名称を探し、同じところから錠剤の写真、薬効分類、服薬指導も取り込みます。かすれて印刷された薬の名前を一文字ずつ写すより、番号で探すほうが名前がずれる余地が小さくなります。
薬袋には手順が一つ多くあります。薬袋にはこの番号が印刷されていないため、文字認識が読み取った文章を言語モデルがもう一度整理し、薬の名前と服用の数字を取り出します。言語モデルとは、ChatGPT のように文章を理解して整理するAIです。このモデルに与えた指示文の核心は、日本語に訳すと次のとおりです。「読めなければ null である。似た薬の名前に置き換えたり、補完したりするな。文字を作り出すことは、抜け落とすことより悪い。」ここでの null は「値なし」という意味です。
待っている間、画面は今何をしているのか、どれくらいかかるのかを知らせます。処方箋では「通常9秒ほどかかります」と表示し、経過時間を数えます。予想よりかなり長引くと数字を引っ込め、「もう少しかかっています」に文言を変えます。守れない数字を表示し続けないためです。
読み取れなかった行は「不明」として残す
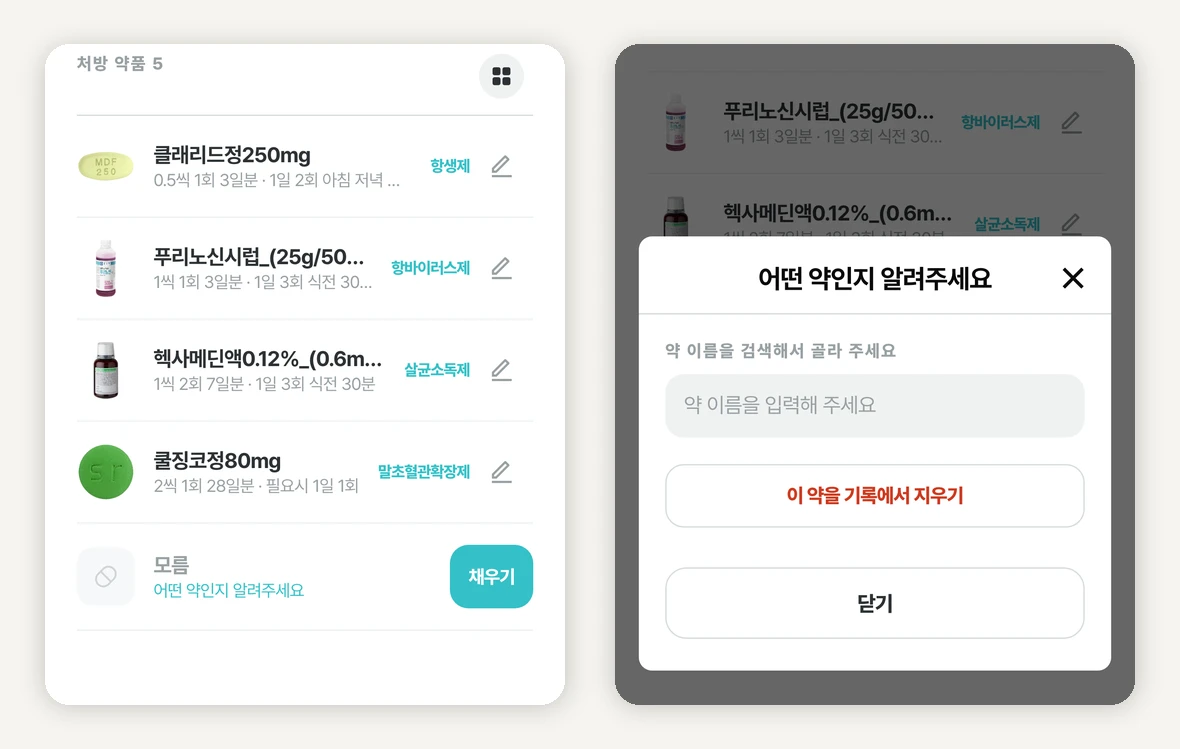
結果画面には、読み取った薬がリストとして入ります。名前の横に錠剤の写真と薬効分類が付き、下の行に1回の投薬量・回数・日数と飲み方が書かれます。
しかし、OCRはすべての行を読み取れるわけではありません。しわの寄った紙、にじんだインク、斜めの角度は常にあります。このとき楽な道は二つあります。読めなかった行を黙って消すか、いちばん似た薬で埋めるかです。PillCheck はどちらもしません。服薬記録から1行が消えれば相互作用のチェックからその薬が漏れ、似た名前の別の薬が入れば間違った薬について案内することになるからです。
そこで、読み取れなかった行は「不明」(모름)という枠として残ります。何行目が空いているかが記録にそのまま残り、ユーザーが「入力」(채우기)を押すと、薬の名前を検索して選ぶことも、その行を記録から削除することもできます。薬を変える方法は、検索して選ぶことの一つだけです。名前を自由に入力できるようにすると、医薬品データとつながらない記録ができてしまうからです。1回の投薬量・回数・日数は直接修正できます。
薬袋の指示文にある「文字を作り出すことは、抜け落とすことより悪い」と同じ原則です。服薬記録では、知らないことを知らないと示すほうが、知っているふりをするより安全です。
個人情報をどう避けたか
処方箋1枚には、患者の氏名、住民登録番号、医療機関と連絡先が一緒に印刷されています。PillCheck に必要なのはそのうち医薬品の表です。とはいえ、写真から必要な部分だけを選んで送ることはできないため、写真はサーバーと文字認識サービスを通過します。この事実は隠さず、画面の告知に書きました。その代わり、設計の目標を「残さないこと」に置きました。
残さない仕組みは三重です。第一に、PillCheck のサーバーは写真を保存しません。読み取りが終われば、服薬リストに移す値だけが残ります。第二に、サーバーがスマートフォンに返す読み取り結果には、患者の氏名・住民登録番号・電話番号を入れる欄が最初からありません。欄がなければ、誤って入り込む場所もありません。そのうえで、結果を送り出す直前に、住民登録番号や電話番号の形をした文字が混じっていないかをもう一度検査します。第三に、サーバーの記録には何行読んだかといった件数だけを残し、読み取った内容は残しません。
告知文そのものもコードと結びつけました。告知の重要な文は自動テストが守っていて、それが消えたり変わったりすると、テストが先に知らせます。約束した文と実際の動作が、誰も気づかないうちに食い違うことを防ぐためです。
「ご本人の処方箋だけを登録してください」という最初の一文も意図したものです。家族の処方箋を撮ってみるよう勧める文言は、わざと置いていません。記録の持ち主が知らない記録を作らないためです。薬袋タブは処理の段階が一つ多いぶん告知文も別に用意していて、撮る前に同じ場所で確認できます。
テストデータは作った処方箋と隠した処方箋
OCRを作るには、処方箋がたくさん必要です。読み取り、採点し、直し、また読み取る必要があるからです。そこに実際の処方箋をそのまま使えば、開発の過程そのものが個人情報を回すことになります。そこで材料を二種類に限りました。
一つ目は合成処方箋です。合成データとは、実物をまねて新しく作ったデータのことです。4種類の処方箋の書式に、患者・医師・医療機関・連絡先・番号をすべて架空で入れ、医薬品の欄にだけ実際の薬のリストを使いました。住民登録番号は最後の検証数字をわざと間違えて作り、偶然でも実在する番号と重ならないようにしました。きれいな原本のほかに、スマートフォンで撮ったように少し縮め、傾け、ぼかした版もあわせて作りました。この記事の画面と使い方動画に映っている処方箋が、この合成版です。
二つ目は隠した実物です。実際の文書は、医薬品の表だけを残して残りをすべて黒く塗りつぶしたものだけを使いました。要点は、隠す基準を「消す場所」ではなく「残す場所」で決めたことにあります。表の見出しを基準に表の領域だけを残し、見出しが見つからなければファイル自体を作りません。失敗しても、隠しきれていない文書が漏れ出る道がありません。自動検査を通った後も、人が1枚ずつ見直しました。
開発の過程でAIをどう使ったか
PillCheck OCR は、AIコーディングエージェントと一緒に作りました。AIコーディングエージェントとは、人の指示を受けてコードを自分で読み、直し、実行してみるAIです。ここでは Claude Code を使い、OCRに関わるコード変更の記録の大半に、このエージェントが共同作成者として記録されています。
ただし、AIに任せなかったことがあります。何を合格とみなすかの基準です。AIが出した結果を三つの方法で縛りました。
一つ、合格ラインを先に書きました。採点の前に「これくらいは合っていなければならない」という基準値をファイルに書いて保存し、基準を書いた時点が採点より遅ければ、その点数は無効にします。結果を見た後で合格ラインをこっそり動かすことを、人にもAIにもできないようにしたのです。
二つ、わざと壊してみました。テストが本当に守ってくれるかを確かめるため、コードの重要なつながりをわざと切った版を作り、テストが失敗を知らせるかを見ます。これをミューテーションテストといいます。たとえば「不明」行を検索で埋めたのに、その薬の識別番号が記録されないように壊すと、必ず失敗しなければならないテストがあります。
三つ、別のAIに反対側を任せました。企画書は、計画・設計・批判の役割を分けたAIたちが合意するまで練り上げ、実装はほかの会社のAIモデルに欠点を探すよう別途レビューさせました。同じモデルが書いて同じモデルが見直すと、同じところを見落とすからです。
AIエージェントに個人情報を見せないのも同じ原則です。実物の文書を隠す作業の文字認識は外部サービスではなく作業するコンピューターの中で動かし、エージェントには隠した後の結果だけを渡しました。隠す前の文字は、エージェントの対話画面に入っていません。
使い方動画も同じ原則で作った
1分あまりの使い方動画もAIで作りました。画面は自動で操作するブラウザで実際に運営中の www.pillcheck.co.kr から撮り、ナレーションはAI音声で合成し、場面はコードで組み立てました。
カメラに映った処方箋は、先に述べた合成版です。読み取り結果を得るために、実際のアカウントでログインして読み取りを動かすこともしていません。読み取りのリクエスト一つだけを、合成処方箋の正解表から作った応答で代わりに返させ、錠剤の写真・薬効分類・検索結果といった残りの画面は、運営中のサービスの実際の値をそのまま受け取りました。正解表とは、合成するときに一緒に書き留めておいた、その処方箋の内容です。そのため、動画制作で読み取りの費用が発生することも、誰かのアカウントに記録が残ることもありませんでした。
動画はこちらで見られます(韓国語)。https://youtu.be/q5hYerY6ZO0
個人情報が絡むAI機能を作るときに持ち帰れること
PillCheck OCR で使った方法のうち、ほかの業務にも移せるものは三つです。
第一に、送るものと残すものを分けて約束します。写真を送らなければ機能が動かないなら送ると書き、その代わり何を残さないかを具体的に書きます。「安全に処理します」のような文は約束ではありません。
第二に、テストデータは作ったものから使います。AIに実際の顧客の文書を貼り付ける前に、同じ書式に偽の値を入れた文書でまず試してください。合成版で確かめられることは、合成版で終わらせます。
第三に、知らないことを知らないと示す場所を作ります。AIが空欄をもっともらしく埋めてくれると便利に見えますが、薬・お金・契約のように間違えると困ることでは、空いていると知らせてくれるほうがよいのです。今日AIに文書の整理を任せるなら、指示文に一行加えてみてください。「読めなければ空欄のままにし、似た値で埋めるな。」