第1編で投げた問い
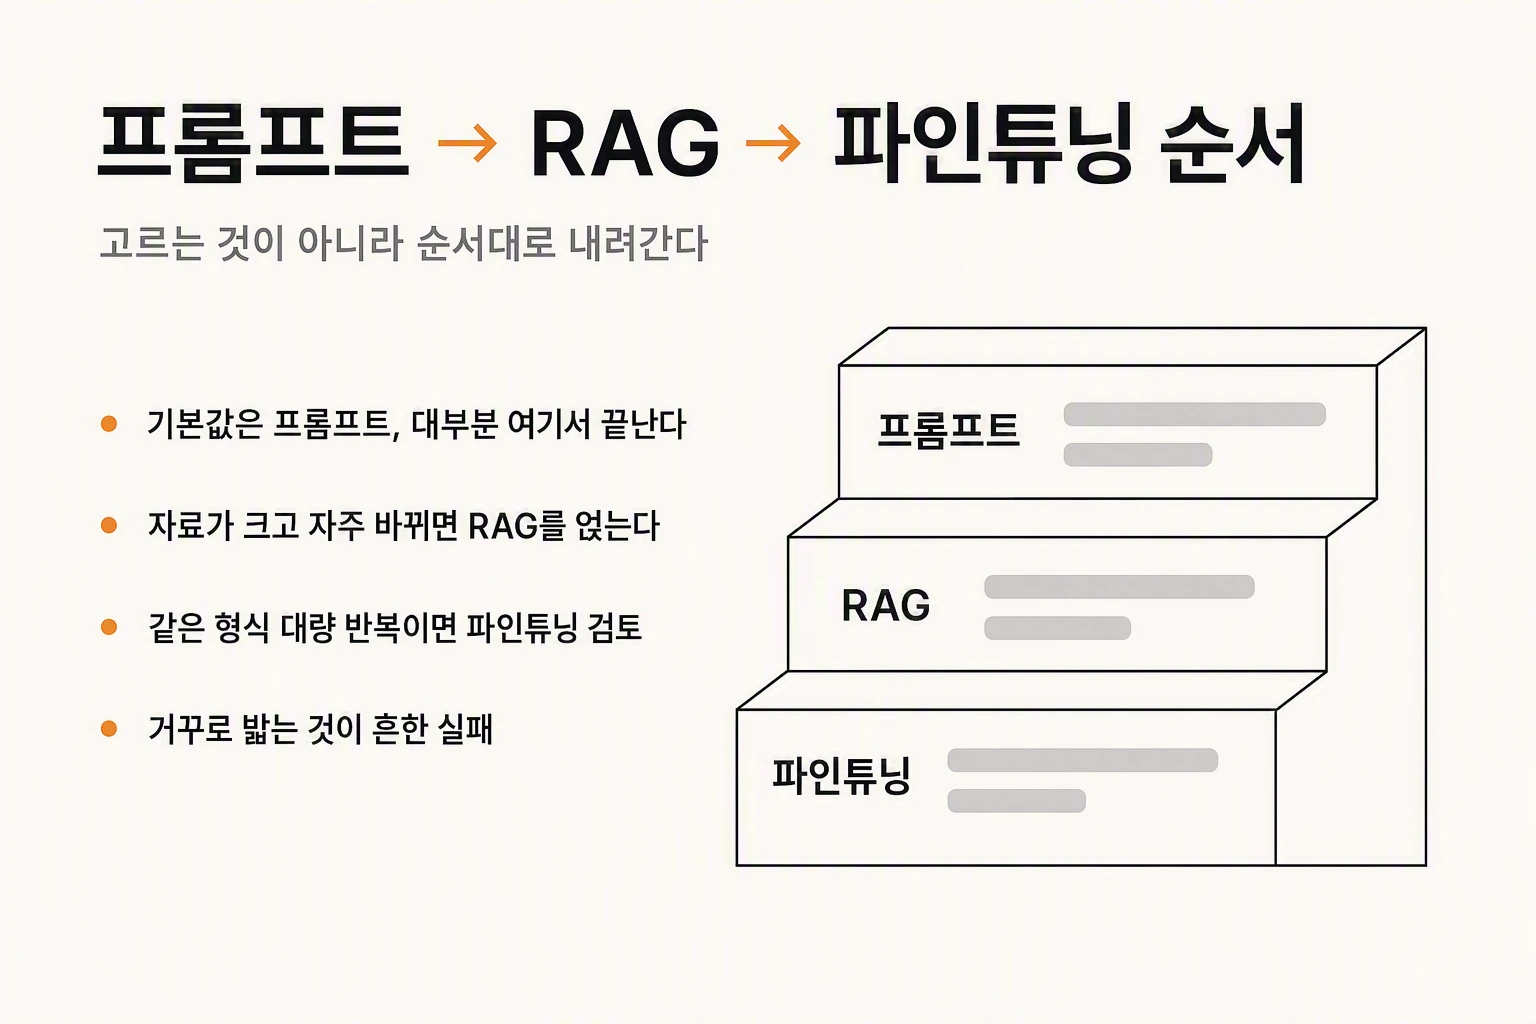
この連載は一つの問いから始まった。ある問題に出会ったとき、それをプロンプトで解けるのか、RAGが必要なのか、ファインチューニングまで行くべきなのかを、何によって分けるのか。
この問いが難しい理由は、三つが互いに異なる層にあるからだ。プロンプトは入力を変える仕事であり、RAGは入力に入れる材料を探してくる仕事であり、ファインチューニングはモデル自体を変える仕事である。
前の五編でその構造をすべて見た。これで、それぞれがどこに作用するのかで基準を立てられる。
既定値はプロンプトである
結論から言うと、実務で出会う問題のほとんどはプロンプトと指示で解ける。これが既定値であり、残りの二つは特定の条件が付いたときに追加するものだ。
理由は第5編で見た。プロンプトは候補リストの形を変える仕事である。「うちの昼食のメニューは」の前に「家の前に和食店が開店した」を付けると、候補の上位がまるごと変わった。モデル内部に触れなくても出力が大きく変わる。
そしてプロンプトは即座に直せる。デプロイも再学習も必要なく、間違っていれば文を変えてもう一度回せばよい。この回転速度は他の二つと比べものにならない。
付け加えると、最近言われるエージェントやスキルの設計も原理はここに属する。ただ文を打つことと、流れと道具を設計することは難易度が違うが、モデル内部を変えずに入力で振る舞いを規定するという点では同じ層である。
RAGを重ねるべき条件
RAGはRetrieval Augmented Generationの略である。必要な資料を探してきてプロンプトに入れてやり、その状態で答えを作らせる方式だ。
動作は第4編の埋め込みとつながる。文書を切って、各断片を意味を含んだ数字の束に変えて保存しておく。質問が入ってくると質問も同じやり方で変えて、保存されたものの中から意味が近い断片を探す。その断片をプロンプトに差し込む。
ここで重要なのは、RAGが結局プロンプトに材料を入れる仕事だという点だ。モデルは変わらない。第5編で見た「文脈が候補を狭める」を自動化したものに近い。
重ねるべき条件は二つだ。第一に、答えの根拠となる資料がコンテキストの上限より大きい。社内規定の全体を毎回入れることはできない。第二に、資料が頻繁に変わる。文書が更新されるたびにモデルを学習し直すのは、コストが成り立たない。
付け加えると、すべて入れられるとしても、すべて入れるのが常に良いわけではない。第4編で見たようにアテンションはすべてのトークン対の関係を測るので、入力が長くなるほど計算が大きくなり焦点もぼやける。必要なものだけ選んで入れるほうが良い場合が多い。
ファインチューニングへ下りる条件
ファインチューニングは第3編で見たとおり、モデルのパラメータを調整する仕事である。三つの中で唯一モデル自体を変える。
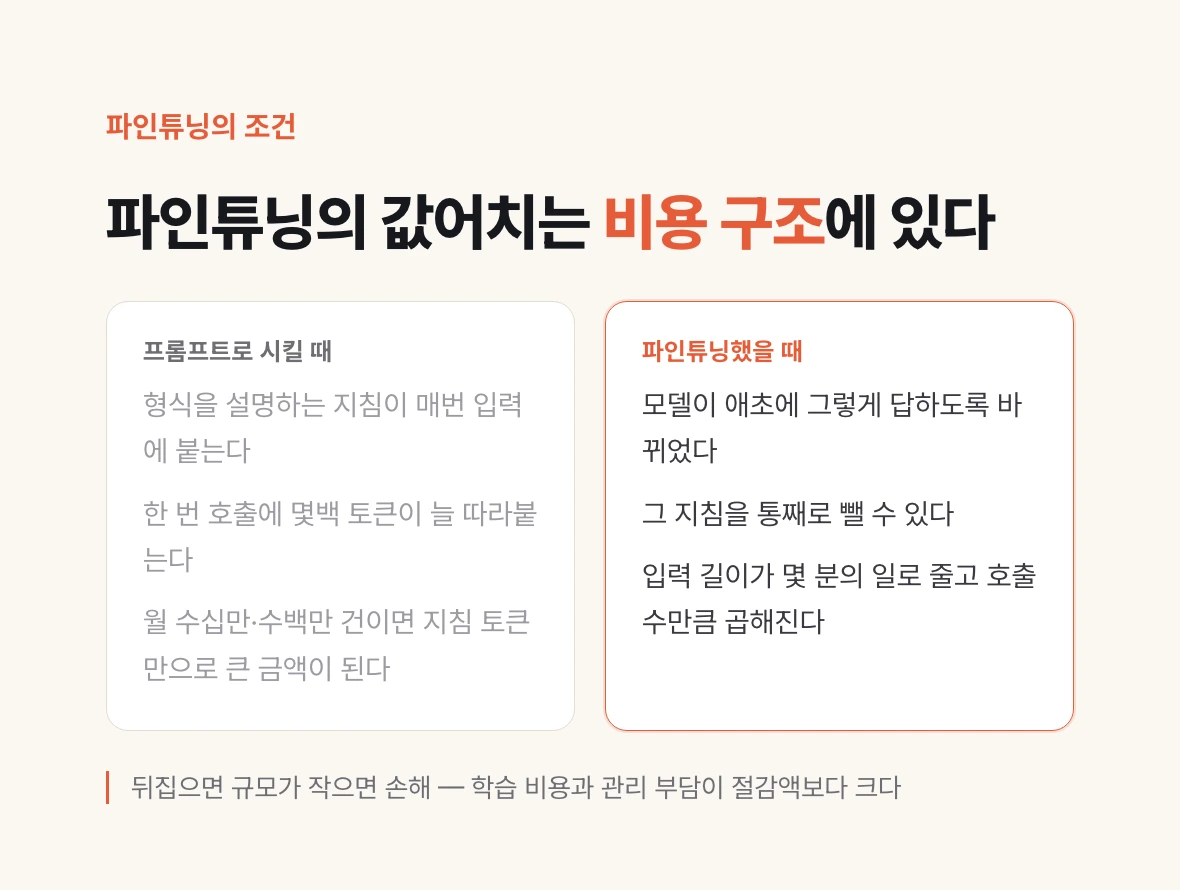
だから最も重く、その分だけ条件が狭い。整理すると、三つが重なるときだ。形式が決まった同じ振る舞いの反復、特化した一つの課題、そして規模である。
核心は三つ目だ。そしてその理由は、この連載を読んだ人にだけ正確に見える。
たとえば決まった形式の結果だけを出させる仕事があるとしよう。プロンプトでやらせるには、形式を説明する指示が毎回入力に付く。一回の呼び出しに数百トークンが常に付いてくるわけだ。呼び出しが一日数件なら何の問題もない。ところが月に数十万、数百万件になれば、その指示のトークンだけで大きな金額になる。
ファインチューニングをすれば、その指示をまるごと外せる。モデルが初めからそう答えるように変わったからだ。入力の長さが数分の一に減り、その差が呼び出し数だけ掛けられる。つまりファインチューニングの実質的な価値は、性能よりコスト構造にある場合が多い。
裏を返せば、規模が小さければファインチューニングは損だ。学習コストと管理の負担が節約額より大きい。
ファインチューニングの居場所が狭くなった理由
以前はファインチューニングがより頻繁に選ばれた。ベースモデルの基本性能が今ほどではなく、プロンプトを扱う方法論も整理されていなかったからだ。
その二つが上がってきたことで、ファインチューニングでしかできなかった仕事のかなりの部分がプロンプトに移ってきた。だから今はファインチューニングの居場所が以前より特殊である。
実務でこの誤解がよく現れる。「うちのデータで学習させよう」という要求がおおむねそれだ。第2編で見たとおり、学習はモデル内部の値を変える仕事であり、社内文書を回答に反映させたいという要求とは筋が違う。その要求はほとんど常にRAGの領域だ。
ただし知っておくことと使うことは別だ。実習環境が安くなって自分で試すのは難しくないので、判断の根拠として持っていればよい。
整理すると順序である
三つを並べて選ぶのではなく、順に下りていくと見るほうが正確だ。
まずプロンプトで試す。ほとんどはここで終わる。答えの根拠となる資料が多く頻繁に変わるならRAGを重ねる。実務で最も多い組み合わせがプロンプト足すRAGだ。それでも同じ形式の大量反復のせいでコストが問題になるなら、そのときファインチューニングを検討する。
この順序を逆に踏むのがよくある失敗だ。ファインチューニングから検討すると、時間と費用を使ったうえでプロンプトで済んだ仕事だったと確認することになる。
| 方式 | 何を変えるか | こういうときに使う | 弱点 |
|---|---|---|---|
| プロンプト・指示 | 入力 | ほとんどの場合。既定値 | 毎回入力に付いて長さとコストになる |
| RAG | 入力に入れる材料 | 根拠資料が多いか頻繁に変わるとき | 探してきた断片が間違っていれば答えも間違う |
| ファインチューニング | モデルのパラメータ | 同じ形式を大量に繰り返しコストが問題のとき | 学習・管理コスト。規模が小さければ損 |
モデルは何で選ぶのか
方式を決めたらモデルを選ぶが、ここで順序を取り違える場合が多い。性能比較表から開くことだ。
実務で先に来るのは制約である。社内網でだけ回さなければならないのか、クラウドに上げてもよいのか。これがAPIを使うかモデルを自分で立てるかを分ける。そして顧客企業や自社のガバナンスとコンプライアンスに、すでに制約がかかっている場合が多い。特定の提供者しか使えないところもよくある。
その制約の中で残る選択肢を前にコストを最適化するのが実際の順序だ。そしてここで第1編の内容が再び関わってくる。コストは単価だけでは決まらない。トークナイザが韓国語をどれだけ細かく刻むかによって、同じ文章でもトークン数が変わる。単価とトークン数を一緒に見なければならない。
最後に、モデルは固定するものではない。より良いものが出れば差し替えるし、作業の種類によって複数のモデルを使い分けることもある。だから設計するときにモデルを差し替えられるようにしておくほうが良い。
六編を終えて
トークンから始まり、学習と推論を過ぎ、実務の判断まで来た。整理するとこうだ。文章はトークンになり、次のトークン当てでパラメータが整えられ、ポストトレーニングで形式を身につけ、推論ではアテンションで関係を測り、最後に確率で一つを引く。
この絵を持っていると変わることがある。LLMに関する話を聞いたとき、それがどの段階の話なのかが分かり、筋が通っているかどうかがふるいにかけられる。「学習させよう」と「文書を参照させよう」が違う話だということが、すぐに見える。
AXで実際に難しいのは技術ではなく、問題を正確に定義することだ。ただし問題を定義するには何が可能で何が高くつくのかを知らなければならず、この六編がその判断の土台を敷いてくれる。