前回は候補まで出てきた
前回は層をすべて通過して、次のトークンの候補とそれぞれの確率が作られた。ところが答えはまだ一文字も出ていない。
残った仕事は一つだ。その候補の中から実際に何を選ぶのか。この段階をサンプリングと呼ぶ。
短い段階だが実務に与える影響は大きい。APIで触る値のほとんどがここに関わっており、同じ質問でも答えが毎回変わる理由もここにある。
1位を常に選ぶわけではない
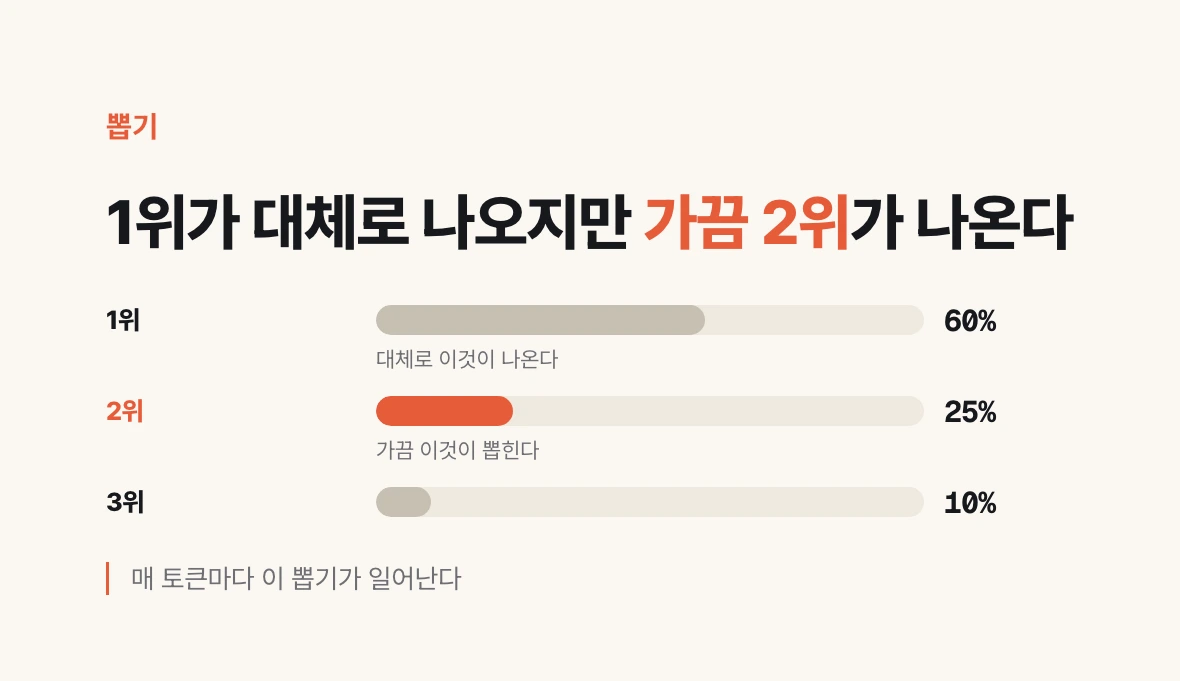
最も確率の高いトークンを常に選べばよさそうに思える。ところがそうはしない。
そうすると同じ入力にはいつも同じ答えが出る。予測可能な代わりに文章が単調になり、一度ずれた方向に入ると同じ場所を回り続ける。
だから確率に従って一つを引く。1位が60%、2位が25%、3位が10%なら、たいていは1位が出るが、たまに2位が出る。トークンごとにこの抽選が起きる。
これが同じ質問でも答えが毎回少しずつ違う理由だ。前回強調したとおり、モデルが学習したからではない。パラメータは固定されており、変わるのは最後の抽選の結果だ。
temperature — 候補をどこまで開けておくか
その抽選の範囲を決める値がtemperatureだ。名前のとおり温度であり、感覚も名前と合っている。
温度を上げると下位の候補まで引かれる余地が生まれる。結果が多様になり、よく創造的と呼ばれる方向に向かう。温度を下げると上位だけが引かれる。結果が安定し、繰り返し実行しても似た答えが出る。
では常に上げればよいのか。そうではない。開きすぎると文脈から外れたトークンまで入ってくる。「우리 점심 메뉴는」(私たちの昼食のメニューは)の次に、食べ物ではなく見当違いの言葉がつく、といった具合だ。逆に下げすぎると文章が硬くなり、同じ表現を繰り返す。
実務の感覚は単純だ。形式が決まった出力、分類、抽出、コード生成には低く。文案の下書き、アイデアの列挙のように複数案が必要なときは高く。迷ったら低いほうから始めて、必要な分だけ上げる。
top-kとtop-p — 切り方が二つある
temperatureとともによく見かけるのがtop-kとtop-pだ。どちらも候補リストを切る値だが、切る基準が違う。
top-kは個数で切る。kが40なら確率上位40個だけを残し、残りは捨てる。単純だが状況を見分けられない。答えが明白で1位が圧倒的な場面でも40個を残し、候補が似たり寄ったりの場面でも40個しか残さない。
top-pは累積確率で切る。pが0.9なら確率を上から足していき、0.9になるところまでだけを残す。1位が圧倒的なら一つか二つだけ残り、候補が拮抗していれば複数が残る。状況に応じて自動的に幅が調節されるわけだ。
だから最近はtop-pを使う側が多い。三つを同時に触る必要はない。たいていはtemperature一つで十分で、出力がやたらと跳ねるならtop-pを一緒に締める。
文脈が候補をあらかじめ狭める
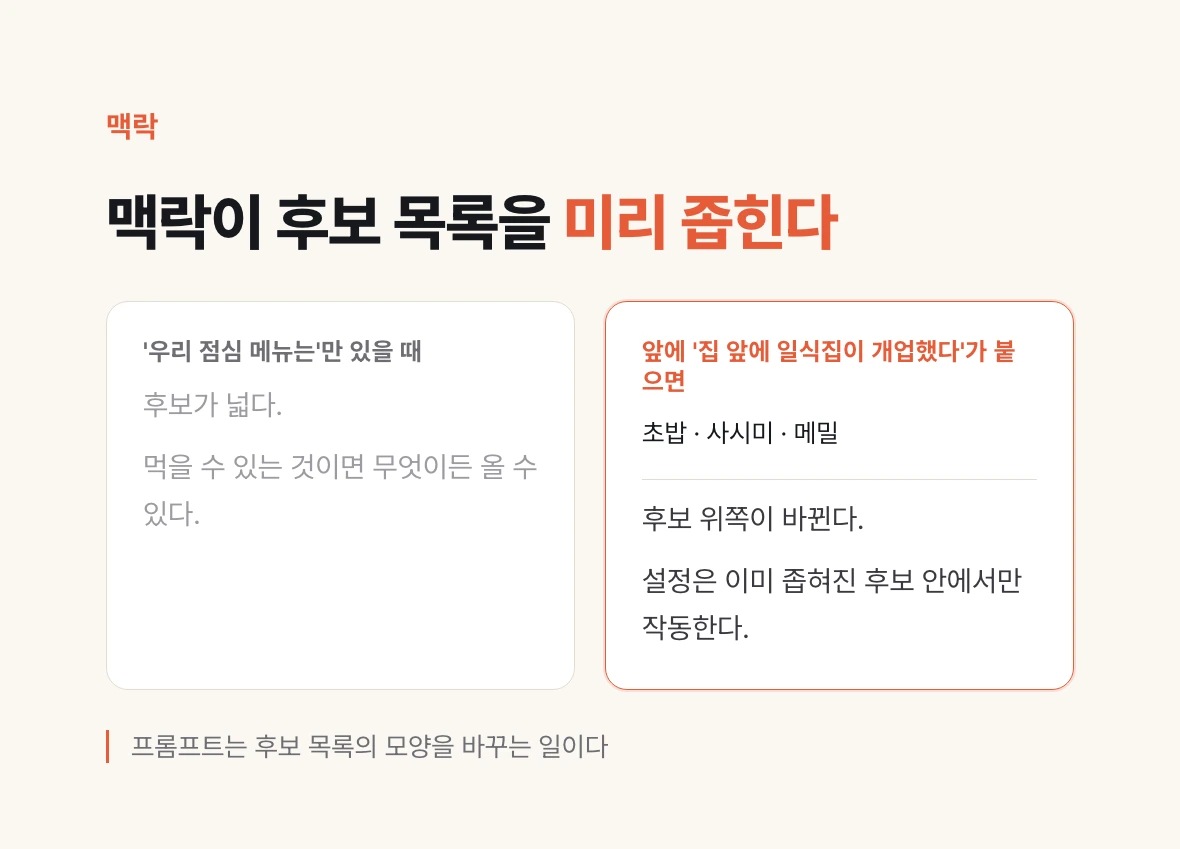
ここでよく見落とされることがある。候補リストそのものが、前の文脈によってすでに変わっているという点だ。
「우리 점심 메뉴는」(私たちの昼食のメニューは)だけなら候補は広い。食べられるものなら何でも来られる。ところが前に「집 앞에 일식집이 개업했다」(家の前に和食店が開業した)がつくと、候補の上位が寿司、刺身、そばのようなものに変わる。
temperatureを触る前に、この事実を先に使うほうがよい。望む方向があるなら、設定値を締めるより文脈を明確に与えるほうが、たいてい効果が大きい。設定はすでに狭められた候補の中でしか働かないからだ。
プロンプトをうまく書けという助言が漠然と聞こえていたなら、この図で見ると具体的になる。プロンプトとは候補リストの形を変える作業だ。
最初の応答は遅く、その後は速い理由
トークンを一つ引いた。ところが答えは普通、数百個のトークンでできている。次のトークンを引くには、いま引いたトークンまで含めてもう一度計算しなければならない。
そうなるとトークンごとに、前回見た重い計算を丸ごと繰り返さなければならないように思える。実際にそうすると、一文字出るのに相当な時間がかかる。
ところが画面では最初だけ少し止まり、その後は文字が速く続く。前の部分の計算結果を保存しておいて再利用するからだ。開発でいうキャッシングと同じ概念で、ここではKVキャッシュと呼ぶ。
だから体感速度は二つの区間に分かれる。入力全体を最初に計算するプリフィル区間は入力が長いほど遅く、その後に一文字ずつ出てくる区間は相対的に一定だ。応答が遅いと感じたとき、どちらが問題なのかを見れば対処が分かれる。前が遅いなら入力を減らし、後ろが遅いなら出力を減らすか、より速いモデルを使う。
止まることもトークンだ
ではモデルはいつ止まるのか。ある瞬間に自ら判断するのではない。
語彙表には目に見える文字のほかに特殊なトークンも入っており、その中に「ここで終わり」を意味するストップトークンがある。次のトークンとしてこれが引かれると生成が止まる。
つまり止まることも、他のトークンと同じように確率で引かれる対象だ。そしてどこで止まるのが適切かは、第3回で見たポストトレーニングの過程で学習される。質問に答え終えたら止まるべきだという感覚が、そのときに身につくのだ。
答えが中途半端に切れたり、必要以上に長くなったりする現象も、この観点で見れば理解しやすい。最大出力長の制限に引っかかったのか、ストップトークンが早く引かれたのかによって対処が違う。
ここまでが推論だ
入力をトークンに変え、埋め込み、層を通過させて候補を出し、確率に従って一つを選んでつなげていき、ストップトークンで止まる。これがLLMが答えを作るすべてだ。
これで五回にわたって学習と推論をすべて見た。残っているのは、この知識を実務の判断に移す作業だ。
最終回では、第1回の冒頭で投げかけた質問に答える。どの問題をプロンプトで解き、RAGで解き、ファインチューニングまで行くのかを、何で分けるのか。